Expresiones regulares en Python — ejercicios con validadores, DNIs escondidos en un informe y dos logs que unificar (y la alerta que decía «Todo bien»)
Después de la práctica me animé y escribí un mini script de alertas: si la última línea del log tenía un 500 (error del servidor) como palabra suelta, debía avisarme. Usé la frontera de palabra para no confundirlo con un 15000 de bytes, como aprendí en la teoría. Lo probé con una línea que tenía un 500 clarísimo, y el script contestó, muy tranquilo: «Todo bien».
Repasé el patrón diez veces: \b500\b, perfecto. El fallo estaba justo delante: había escrito "\b500\b" **sin la r**. Python convirtió cada \b en un carácter de retroceso antes de que el patrón llegara a re, y mi script buscaba «retroceso, 500, retroceso», algo que no aparece en ningún log del mundo. Sin error, sin aviso: solo una alerta que nunca iba a sonar. Es el primer fragmento de «¿Qué falla aquí?», y los otros dos son igual de silenciosos.
Hoy practicamos con tres ejercicios de dificultad creciente, tres fragmentos para depurar y un chuletario para llevarte. Estos ejercicios usan la teoría de expresiones regulares y repasan lo de la práctica. Puedes hacerlos sin ellas, pero te costará más.
Tabla de Contenidos
Cómo usar este artículo
- Lee el enunciado de un nivel y no mires la solución todavía.
- Escribe tu versión, ejecútala y compara tu salida con la esperada.
- Si te atascas, mira solo la 🔵 pista y vuelve a intentarlo.
- Cuando termines, compara con la solución y fíjate en por qué está hecha así, no solo en que dé la misma salida.
Ningún ejercicio usa input(): los datos van fijos en el código. Con las expresiones regulares, que tu salida coincida no basta: prueba también tu patrón con textos que no deberían encajar. Un patrón que lo acepta todo también «da la salida esperada» con los ejemplos buenos.
Nivel 1 · Básico: validar los campos de una alerta
Enunciado. Antes de dar de alta una alerta, el sistema comprueba que cada campo tiene el formato correcto. Escribe un diccionario PATRONES con un patrón para cada campo:
- IP: cuatro números de 1 a 3 cifras separados por puntos.
- Hora:
hh:mm:sscon las horas de00a23y los minutos y segundos de00a59. - Código: un código HTTP, de
100a599. - Ruta: empieza por
/y sigue con letras, cifras,_,/,.o-.
Comprueba con estas pruebas cada valor con re.fullmatch y, para comparar, también con re.match, y muestra una tabla con ✔ o ✘:
PRUEBAS = [
    ("IP", "10.0.0.7"), ("IP", "10.0.0"), ("IP", "10.0.0.7 "),
    ("Hora", "09:15:02"), ("Hora", "9:15:02"), ("Hora", "24:00:00"),
    ("Código", "404"), ("Código", "4040"), ("Código", "704"),
    ("Ruta", "/fp1/tema8.pdf"), ("Ruta", "fp1/tema8.pdf"),
]
Salida esperada:
Campo   Valor             fullmatch  match
IP      '10.0.0.7'        ✔          ✔
IP      '10.0.0'          ✘          ✘
IP      '10.0.0.7 '       ✘          ✔
Hora    '09:15:02'        ✔          ✔
Hora    '9:15:02'         ✘          ✘
Hora    '24:00:00'        ✘          ✘
Código  '404'             ✔          ✔
Código  '4040'            ✘          ✔
Código  '704'             ✘          ✘
Ruta    '/fp1/tema8.pdf'  ✔          ✔
Ruta    'fp1/tema8.pdf'   ✘          ✘
Para las horas no basta con \d\d: piensa en una alternativa entre «un 0 o un 1 seguido de cualquier cifra» y «un 2 seguido de una cifra de 0 a 3». Para el código, la primera cifra es un conjunto de 1 a 5. Y para la IP, repite tres veces un grupo sin captura (?:…).
Nivel 2 · Intermedio: los DNI escondidos en un informe de incidencias
Enunciado. El informe de incidencias del campus virtual lo escribe cada técnico a su manera, y los DNIs aparecen pegados a la letra, separados por un guion o por un espacio, y con la letra en minúscula:
INCIDENCIAS = """\
09:15 el usuario 12345678Z no recuerda su contraseña
09:31 bloqueado 87654321-x tras tres intentos
10:02 el 45123456 D pide que se reabra la entrega
10:40 teléfono de contacto: 928451000 (no es un DNI)
11:05 alta de 11111111A y de 2222222-J
"""
Encuentra todos los DNIs (ocho cifras y una letra, con un guion, un espacio o nada en medio) con un solo patrón. Para cada uno, muestra el texto tal como aparece, el DNI normalizado (cifras y letra en mayúscula, todo junto) y si la letra es correcta. La letra correcta es LETRAS[numero % 23], con LETRAS = "TRWAGMYFPDXBNJZSQVHLCKE", como en el tema de strings. Termina con un resumen.
El teléfono (nueve cifras) y 2222222-J (siete cifras) no son DNIs y no deben aparecer.
Salida esperada:
Encontrado    Normalizado  Letra
'12345678Z'   12345678Z    correcta
'87654321-x'  87654321X    correcta
'45123456 D'  45123456D    correcta
'11111111A'   11111111A    debería ser H
DNIs: 4, con la letra correcta: 3
Dos grupos, uno para las cifras y otro para la letra, con [- ]? entre ellos. Para no encontrar ocho cifras dentro del teléfono, rodea el patrón con fronteras de palabra \b. Y como hay varios DNIs y quieres sus grupos, recorre las coincidencias con re.finditer.
Nivel 3 · Desafío: unificar dos logs con fechas distintas
Enunciado. Dos servidores escriben sus logs con formatos de fecha distintos: el A usa día-mes-año (con / o con -) y el B, año-mes-día. Además, alguna línea se escribió a mano y tiene los separadores mezclados:
SERVIDOR_A = """\
12/10/2026 09:15:02 10.0.0.7 GET /campus/inicio 200
12-10-2026 09:31:08 192.168.1.66 POST /campus/login 401
12/10-2026 09:40:00 10.0.0.9 GET /fp1 200
"""
SERVIDOR_B = """\
2026-10-12 09:20:17 172.16.4.150 GET /fp1/tema8.pdf 200
2026-10-12 10:02:33 10.0.0.41 GET /fp1/entregas 500
2026/10-12 10:05:12 10.0.0.41 GET /fp1/entregas 200
"""
Escribe una función normalizar(linea) que devuelva la línea con la fecha en año-mes-día con guiones, o None si la fecha no es válida. Una fecha día-mes-año solo es válida si usa el mismo separador dos veces. Junta las líneas válidas de los dos servidores, marcando su origen, ordénalas cronológicamente y muéstralas. Después, lista las rechazadas y cuenta cuántas peticiones tienen un código de error (4xx o 5xx).
Salida esperada:
2026-10-12 09:15:02 10.0.0.7 GET /campus/inicio 200  [A]
2026-10-12 09:20:17 172.16.4.150 GET /fp1/tema8.pdf 200  [B]
2026-10-12 09:31:08 192.168.1.66 POST /campus/login 401  [A]
2026-10-12 10:02:33 10.0.0.41 GET /fp1/entregas 500  [B]
Rechazadas:
  A: 12/10-2026 09:40:00 10.0.0.9 GET /fp1 200
  B: 2026/10-12 10:05:12 10.0.0.41 GET /fp1/entregas 200
Peticiones: 4, con error: 2
Para el «mismo separador», captura el primero en un grupo y exige después una referencia a ese grupo. re.subn con una plantilla reordena la fecha y, a la vez, te dice si ha encajado. Una vez todas las fechas están en año-mes-día, sort() sobre las líneas las deja en orden cronológico.
¿Qué falla aquí?
Tres fragmentos con un fallo cada uno. Antes de leer la explicación, haz dos cosas: predice si da error y, si no lo da, qué imprime.
Fragmento 1
raw.py
import re

linea = '10.0.0.41 [12/10/2026 10:02:33] "GET /fp1/entregas" 500 87 "Chrome/129"'
if re.search("\b500\b", linea):        # ¿hay un 500 como palabra suelta?
    print("Error del servidor")
else:
    print("Todo bien")
*Piénsalo antes de seguir: la línea tiene un 500 como palabra suelta. ¿Qué imprime python3 raw.py?*
Explicación. No da error, pero se equivoca:
Todo bien
Es mi alerta del principio. El patrón "\b500\b" está escrito **sin r**, y Python procesa las secuencias de escape del string antes de entregárselo a re. \b es una secuencia válida para Python: el carácter de retroceso (código 8). Así que re no recibe «frontera, 500, frontera», sino «retroceso, 500, retroceso». En la línea no hay ningún retroceso, re.search devuelve None y el else imprime «Todo bien».
Confiar en que el patrón «funciona sin r» porque con \d funcionaba. \d no es un escape de Python y llega intacto a re; \b, \1 o \n sí lo son, y se transforman por el camino.
Arreglo. Una r delante del patrón:
import re

linea = '10.0.0.41 [12/10/2026 10:02:33] "GET /fp1/entregas" 500 87 "Chrome/129"'
if re.search(r"\b500\b", linea):       # con r: \b llega a re como frontera de palabra
    print("Error del servidor")
else:
    print("Todo bien")
Al ejecutarlo:
Error del servidor
Si alguna vez dudas de qué ha recibido re, imprime repr(patron). repr("\b500\b") muestra '\x08500\x08': los retrocesos quedan a la vista.
Fragmento 2
avaricia.py
import re

linea = '10.0.0.41 [12/10/2026 10:02:33] "GET /fp1/entregas" 500 87 "Chrome/129"'
peticion = re.search(r'"(.*)"', linea).group(1)   # lo que hay entre comillas
print(peticion)
*Piénsalo antes de seguir: queremos la petición que va entre comillas, GET /fp1/entregas. ¿Qué imprime?*
Explicación. No da error, pero se lleva media línea:
GET /fp1/entregas" 500 87 "Chrome/129
.* es avaricioso: después de la primera comilla, se come el resto de la línea y luego retrocede solo lo justo para que encaje la comilla del patrón, que es la última de la línea, la que cierra "Chrome/129". Todo lo que queda en medio, con dos comillas incluidas, entra en el grupo 1.
Probar el patrón con una línea que solo tiene una pareja de comillas. Ahí "(.*)" funciona, y el fallo aparece con la primera línea real que tenga dos.
Arreglo. Describe lo que puede ir dentro: cualquier cosa menos una comilla.
import re

linea = '10.0.0.41 [12/10/2026 10:02:33] "GET /fp1/entregas" 500 87 "Chrome/129"'
peticion = re.search(r'"([^"]*)"', linea).group(1)   # nada que sea una comilla
print(peticion)
Al ejecutarlo:
GET /fp1/entregas
"(.*?)", con el cuantificador perezoso, también lo arregla. [^"]* tiene una ventaja: aunque el resto del patrón cambie, nunca puede saltarse una comilla, mientras que el perezoso puede acabar estirándose si lo que va detrás no encaja a la primera.
Fragmento 3
match.py
import re

lineas = [
    '10.0.0.41 [12/10/2026 10:02:33] "GET /fp1/entregas" 500 87 "Chrome/129"',
    '192.168.1.66 [12/10/2026 09:31:08] "POST /campus/login" 401 312 "curl/8.5"',
]
for linea in lineas:
    m = re.match(r"\d{3}", linea)      # el código HTTP son 3 cifras
    print(m.group() if m else "sin código")
Piénsalo antes de seguir: queremos el código HTTP de cada línea (500 y 401). ¿Qué imprime?
Explicación. No da error, y las dos respuestas están mal, cada una a su manera:
sin código
192
re.match solo prueba al principio de la línea. La primera línea empieza por 10.0.0.41: después del 1 y el 0 viene un punto, así que no hay tres cifras seguidas en la posición 0, y match devuelve None sin mirar más allá. La segunda empieza por 192.168.1.66, y 192 sí son tres cifras: match encaja con el primer número de la IP y el programa imprime 192 como si fuera el código.
El segundo fallo es el peor: un resultado que parece correcto. Aunque se cambie match por search, \d{3} encontraría el primer grupo de tres cifras de la línea, que tampoco es el código.
Buscar un campo solo por su forma (\d{3}) cuando hay otros campos con la misma forma. En un log, las IPs, las fechas, los bytes y los códigos son todo cifras: lo que distingue al código es dónde está.
Arreglo. search para buscar en toda la línea, y contexto alrededor de las tres cifras para que solo encaje el código: la comilla de cierre y los espacios.
import re

lineas = [
    '10.0.0.41 [12/10/2026 10:02:33] "GET /fp1/entregas" 500 87 "Chrome/129"',
    '192.168.1.66 [12/10/2026 09:31:08] "POST /campus/login" 401 312 "curl/8.5"',
]
for linea in lineas:
    m = re.search(r'" (\d{3}) ', linea)   # search busca en toda la línea; el contexto lo fija
    print(m.group(1) if m else "sin código")
Al ejecutarlo:
500
401
Soluciones
Mira esta sección solo cuando hayas intentado el ejercicio. Si tu código es distinto pero da la misma salida (y rechaza lo mismo), también es una solución válida.
Solución del Nivel 1
validar.py
import re

PATRONES = {
    "IP": r"\d{1,3}(?:\.\d{1,3}){3}",
    "Hora": r"([01]\d|2[0-3]):[0-5]\d:[0-5]\d",   # de 00 a 23 : de 00 a 59 : de 00 a 59
    "Código": r"[1-5]\d\d",                       # los códigos HTTP van de 100 a 599
    "Ruta": r"/[\w/.-]*",                         # empieza por / y luego letras, /, . o -
}
PRUEBAS = [
    ("IP", "10.0.0.7"), ("IP", "10.0.0"), ("IP", "10.0.0.7 "),
    ("Hora", "09:15:02"), ("Hora", "9:15:02"), ("Hora", "24:00:00"),
    ("Código", "404"), ("Código", "4040"), ("Código", "704"),
    ("Ruta", "/fp1/tema8.pdf"), ("Ruta", "fp1/tema8.pdf"),
]

print(f"{'Campo':<8}{'Valor':<18}{'fullmatch':<11}match")
for campo, valor in PRUEBAS:
    bien = re.fullmatch(PATRONES[campo], valor)   # ¿TODO el valor tiene el formato?
    casi = re.match(PATRONES[campo], valor)       # ¿EMPIEZA con el formato?
    print(f"{campo:<8}{valor!r:<18}{'✔' if bien else '✘':<11}{'✔' if casi else '✘'}")
Por qué está hecho así:
- Los patrones se guardan en un diccionario por campo, así que la comprobación es una sola línea para todos:
re.fullmatch(PATRONES[campo], valor). Añadir un campo nuevo es añadir una clave. - La hora usa
([01]\d|2[0-3]): «un 0 o un 1 y cualquier cifra» (de00a19) o «un 2 y una cifra de 0 a 3» (de20a23). Los minutos y segundos,[0-5]\d, van de00a59. Así24:00:00se rechaza por el formato, sin convertir nada a número. - El código es
[1-5]\d\d: la primera cifra de 1 a 5. Por eso704no pasa, aunque tenga tres cifras. - En la ruta,
[\w/.-]*acepta letras, cifras,_, barras, puntos y guiones. El guion va al final del conjunto: puesto entre dos caracteres significaría un rango. Y dentro de los corchetes el punto es un punto normal, sin escapar. - La columna
matchmuestra por qué validar conmatches un error: acepta'10.0.0.7 '(con un espacio detrás) y'4040', porque solo comprueba que el valor empieza bien.fullmatchexige que no sobre nada. '10.0.0'y'9:15:02'fallan con las dos funciones: les falta una pieza (un número de la IP, una cifra de la hora) desde el principio.{valor!r:<18}imprime el valor conrepr, entre comillas. Así se ve el espacio del final de'10.0.0.7 ', que con unprintnormal sería invisible.
\d{1,3} acepta 999.999.999.999, que no es una IP válida (cada número va de 0 a 255). Las regex comprueban formatos; para los rangos de valores, lo más claro es convertir con int() y comparar. Mezclar las dos cosas en un patrón es posible, pero sale un patrón ilegible.
Solución del Nivel 2
dnis.py
import re

LETRAS = "TRWAGMYFPDXBNJZSQVHLCKE"     # la letra del DNI es LETRAS[número % 23] (tema 7)

INCIDENCIAS = """\
09:15 el usuario 12345678Z no recuerda su contraseña
09:31 bloqueado 87654321-x tras tres intentos
10:02 el 45123456 D pide que se reabra la entrega
10:40 teléfono de contacto: 928451000 (no es un DNI)
11:05 alta de 11111111A y de 2222222-J
"""
# 8 cifras (grupo 1), un guion o espacio opcional, y la letra (grupo 2), con fronteras a los lados
DNI = r"\b(\d{8})[- ]?([A-Za-z])\b"

total = correctos = 0
print(f"{'Encontrado':<14}{'Normalizado':<13}Letra")
for m in re.finditer(DNI, INCIDENCIAS):
    numero, letra = m.group(1), m.group(2).upper()
    esperada = LETRAS[int(numero) % 23]
    total += 1
    if letra == esperada:
        correctos += 1
        estado = "correcta"
    else:
        estado = f"debería ser {esperada}"
    print(f"{m.group()!r:<14}{numero + letra:<13}{estado}")
print(f"DNIs: {total}, con la letra correcta: {correctos}")
Por qué está hecho así:
- El patrón
\b(\d{8})[- ]?([A-Za-z])\btiene dos grupos: las ocho cifras y la letra. Lo que hay entre ellos ([- ]?) es «un guion o un espacio, o nada», y no se captura porque no lo queremos en el DNI normalizado. - Las fronteras
\bhacen el trabajo fino. En928451000, las ocho primeras cifras encajan con\d{8}, pero lo siguiente es un0, que no es separador ni letra. El motor intenta empezar en la cifra siguiente, pero ahí no hay frontera (está en medio del número), y así con todas: el teléfono no encaja en ninguna posición. 2222222-Jtiene solo siete cifras, así que\d{8}no encaja. Sin el primer\b, tampoco encajaría, pero el\bdel final es el que evita, por ejemplo, que12345678ZZse tome como un DNI con la letraZ.- **
re.finditer** da unMatchpor cada DNI, con sus grupos. Confindalltendrías tuplas de(cifras, letra), pero no el texto original completo (m.group()), que es el que se muestra en la primera columna. - La letra se pasa a mayúscula con
upper()antes de comparar.87654321-xes un DNI correcto escrito con la letra en minúscula. 11111111Ase encuentra, porque tiene el formato de un DNI, pero su letra no cuadra: 11111111 % 23 = 18, yLETRAS[18]es laH. De nuevo, la regex comprueba la forma y el cálculo comprueba el valor.- El resumen sale de dos contadores: 4 DNIs encontrados, de los que 3 tienen la letra correcta.
total = correctos = 0 inicializa las dos variables a 0 en una sola línea. Funciona bien con números; con listas, en cambio, las dos variables apuntarían a la misma lista.
Solución del Nivel 3
unificar.py
import re

# Dos servidores, dos formatos de fecha (y alguna línea escrita a mano, mal)
SERVIDOR_A = """\
12/10/2026 09:15:02 10.0.0.7 GET /campus/inicio 200
12-10-2026 09:31:08 192.168.1.66 POST /campus/login 401
12/10-2026 09:40:00 10.0.0.9 GET /fp1 200
"""
SERVIDOR_B = """\
2026-10-12 09:20:17 172.16.4.150 GET /fp1/tema8.pdf 200
2026-10-12 10:02:33 10.0.0.41 GET /fp1/entregas 500
2026/10-12 10:05:12 10.0.0.41 GET /fp1/entregas 200
"""
DMA = r"(\d\d)([-/])(\d\d)\2(\d{4}) "   # día, separador, mes, EL MISMO separador, año
AMD = r"\d{4}-\d\d-\d\d "               # ya está en año-mes-día


def normalizar(linea):
    """Devuelve la línea con la fecha en año-mes-día, o None si la fecha no se entiende."""
    nueva, n = re.subn("^" + DMA, r"\4-\3-\1 ", linea)
    if n == 1:
        return nueva
    if re.match(AMD, linea):
        return linea
    return None


unificado, rechazadas = [], []
for origen, texto in [("A", SERVIDOR_A), ("B", SERVIDOR_B)]:
    for linea in texto.splitlines():
        nueva = normalizar(linea)
        if nueva is None:
            rechazadas.append(f"{origen}: {linea}")
        else:
            unificado.append(nueva + "  [" + origen + "]")

unificado.sort()          # con la fecha en año-mes-día, el orden alfabético es el cronológico
for linea in unificado:
    print(linea)

print("Rechazadas:")
for r in rechazadas:
    print("  " + r)

errores = [l for l in unificado if re.search(r" [45]\d\d  \[", l)]   # códigos 4xx y 5xx
print(f"Peticiones: {len(unificado)}, con error: {len(errores)}")
Por qué está hecho así:
DMAes(\d\d)([-/])(\d\d)\2(\d{4}): el grupo 2 captura el primer separador, y\2exige el mismo texto en el segundo hueco.12-10-2026encaja (guion y guion);12/10-2026no (barra y guion). Es exactamente lo que pedía el enunciado, en un solo patrón.normalizarusare.subn("^" + DMA, r"\4-\3-\1 ", linea). El^asegura que la fecha está al principio de la línea. La plantilla escribe el año (grupo 4), el mes (grupo 3) y el día (grupo 1); el separador (grupo 2) no se usa, porque la salida lleva siempre guiones. El espacio del final se repite en la plantilla porque formaba parte de lo que encajó.- Si
nvale 1, la fecha era día-mes-año y ya está convertida. Si no, la función mira conre.match(AMD, linea)si la línea ya estaba en año-mes-día; si tampoco, devuelveNone. Así se rechaza2026/10-12, que no tiene ninguno de los dos formatos. "^" + DMAconcatena dos strings: el"^"no llevarporque no tiene barras, yDMAya se escribió conr. Lo que llega arees el patrón completo, bien formado.- Las líneas válidas se guardan con su origen al final (
" [A]"), y **unificado.sort()** las ordena como texto. Como todas empiezan por2026-10-12 hh:mm:ss, el orden alfabético coincide con el cronológico: las líneas de A y de B quedan intercaladas por hora. - El último patrón,
r" [45]\d\d \[", cuenta los errores: un espacio, un código que empieza por 4 o 5, dos espacios y el corchete del origen. El contexto evita confundir el código con otros números de la línea. Hay 2: el401del servidor A y el500del B.
Míralo paso a paso en Python Tutor
El fallo del fragmento 2 se entiende mucho mejor comparando las dos versiones lado a lado. Python Tutor ejecuta el código línea a línea y muestra el valor de cada variable. Elige Python 3 y pega este programa:
import re

linea = '"GET /fp1" 200 "Chrome/129"'
avaro = re.search(r'"(.*)"', linea)
perezoso = re.search(r'"(.*?)"', linea)
print(avaro.group(1))
print(perezoso.group(1))
Salida esperada:
GET /fp1" 200 "Chrome/129
GET /fp1
Qué observar, paso a paso:
- Después de la línea 3,
lineaes un string con cuatro comillas: dos alrededor de la petición y dos alrededor del navegador. - En las líneas 4 y 5 se crean dos objetos
re.Match,avaroyperezoso, con el mismo texto y casi el mismo patrón: solo cambia una?. - En la línea 6,
avaro.group(1)empieza después de la primera comilla y termina antes de la última: el grupo contiene200y las dos comillas del medio. - En la línea 7,
perezoso.group(1)termina en la segunda comilla, la primera que permite cerrar el patrón: soloGET /fp1. - Cambia el patrón de
perezosoporr'"([^"]*)"'y vuelve a ejecutar: el resultado es el mismo que con.*?.
Chuletario: Expresiones regulares en Python
Lo esencial en 30 segundos
- **
import rey todos los patrones conrdelante:**r"\b\d{3}\b". - Buscar:
re.search(en algún sitio). Validar:re.fullmatch(todo). Al principio:re.match. - Todas las coincidencias:
re.findall(lista de strings) ore.finditer(unMatchcada una). - **Comprueba
None** antes de pedirm.group(). - **Grupos
( )** para trocear:m.group(1),m.groups(). Se numeran por el paréntesis que abre. - **
.*es avaricioso:** para «entre comillas»,"[^"]*"o".*?".
Sintaxis de los patrones
| Quiero… | Patrón | Ejemplo que encaja |
|---|---|---|
| Un dígito / no dígito | \d / \D | 7 / a |
| Carácter de palabra / no | \w / \W | a, 7, _ / . |
| Espacio en blanco / no | \s / \S | espacio, tab / x |
Cualquier carácter (menos \n) | . | a, 7, . |
| Un punto de verdad | \. | . |
| Uno de varios caracteres | [aeiou], [0-9a-f] | e, 3 |
| Cualquiera menos esos | [^0-9] | x |
| Una cosa u otra | GET|POST | POST |
| Opcional | https? | http, https |
| 0 o más / 1 o más | \d* / \d+ | "" / 404 |
| Exactamente n / entre n y m | \d{4} / \d{1,3} | 2026 / 16 |
| Lo mínimo (perezoso) | .*?, \d+? | |
| Principio / final del texto | ^ / $ | |
| Palabra suelta | \b404\b | 404, no 14040 |
| Grupo que captura | (\d\d) | |
| Grupo que no captura | (?:\.\d+){3} | .16.4.150 |
| Lo mismo que el grupo 1 | \1 |
Funciones del módulo re
| Quiero… | Código | Devuelve |
|---|---|---|
| ¿Está en algún sitio? | re.search(p, t) | Match o None |
| ¿Empieza así? | re.match(p, t) | Match o None |
| ¿Es todo así? | re.fullmatch(p, t) | Match o None |
| Todas las coincidencias | re.findall(p, t) | Lista de strings (o de grupos) |
| Recorrerlas con posición | for m in re.finditer(p, t): | Un Match por vuelta |
| Reemplazar | re.sub(p, r"\2/\1", t) | String nuevo |
| Reemplazar y contar | re.subn(p, rep, t) | (string nuevo, n) |
| Comprobar un patrón | re.compile(p) | Patrón o re.error |
El objeto Match
| Quiero… | Código | Ejemplo |
|---|---|---|
| Toda la coincidencia | m.group() o m.group(0) | '[12/10/2026 09:15:40]' |
| Un grupo | m.group(1) | '12' |
| Varios grupos | m.group(1, 2, 3) | ('12', '10', '2026') |
| Todos los grupos | m.groups() | Tupla; None en los que no participan |
| Posición | m.start(), m.end(), m.span() | (52, 55) |
| Posición de un grupo | m.span(4) | (22, 30) |
Plantillas de los ejercicios
Validar un valor (Nivel 1):
if re.fullmatch(r"([01]\d|2[0-3]):[0-5]\d:[0-5]\d", hora):
    print("Hora válida")
Buscar comprobando None (fragmento 3):
m = re.search(r'" (\d{3}) ', linea)
if m:
    codigo = int(m.group(1))
Recorrer todas las coincidencias con sus grupos (Nivel 2):
for m in re.finditer(r"\b(\d{8})[- ]?([A-Za-z])\b", texto):
    numero, letra = m.group(1), m.group(2).upper()
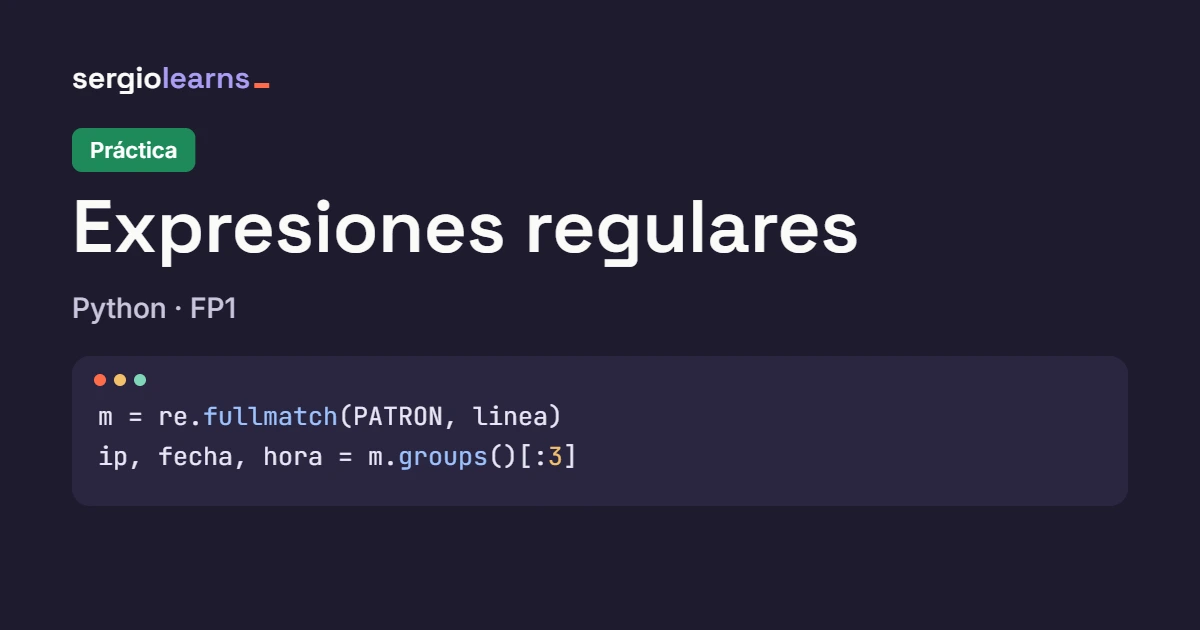
Trocear una línea en campos (práctica):
m = re.fullmatch(PATRON, linea)
if m is None:
    continue
ip, fecha, hora = m.groups()
Reordenar con una plantilla (Nivel 3):
nueva, n = re.subn(r"^(\d\d)([-/])(\d\d)\2(\d{4})", r"\4-\3-\1", linea)
if n == 0:
    print("No tenía el formato")
Errores que más se repiten
| Síntoma | Causa probable |
|---|---|
AttributeError: 'NoneType' object has no attribute 'group' | El patrón no encontró nada y no comprobaste if m: |
Un patrón con \b o \1 no encuentra nada, sin error | Falta la r delante: Python convirtió la barra en un escape |
Se cuela 14040 al buscar 404 | Faltan fronteras: \b404\b |
".*" se lleva media línea | Avaricioso: usa "[^"]*" o ".*?" |
re.match da None con algo que sí está | match solo mira al principio: usa search |
Un validador acepta '4040' o '10.0.0.7 ' | Validas con match o search: usa fullmatch |
10a0b0c7 pasa por una IP | El punto sin escapar: \. |
findall devuelve tuplas o solo un trozo | El patrón tiene grupos: findall devuelve los grupos |
| Un grupo repetido solo guarda el último trozo | (…){3} guarda la última vuelta: usa varios grupos o finditer |
| Los números de los grupos «se mueven» | Añadiste paréntesis: usa (?:…) para los que solo agrupan |
re.error: missing ), unterminated subpattern | Paréntesis sin cerrar en el patrón |
re.sub «no cambia» el texto | Devuelve uno nuevo: t = re.sub(…, t) |
Antes de entregar, pregúntate
- ¿Llevan todos mis patrones y plantillas la
rdelante? - ¿Uso
fullmatchpara validar ysearchpara buscar, y compruebo que el resultado no esNone? - ¿He escapado los puntos, corchetes y paréntesis que quiero encontrar tal cual?
- ¿He probado cada patrón también con textos que no deberían encajar?
Si quieres repasar el tema desde la base, vuelve a la teoría de expresiones regulares.
Sigue aprendiendoTodos los artículos de Python¿Te ha servido este artículo? Así puedes apoyar SergioLearns →